AI圈最大騙局?全球大模型排行榜遭質疑 高分不等於好用
鉅亨網編輯林羿君 綜合報導
 AI新聞摘要
- 1.Hugging Face高層指現有AI評測有侷限,AI代理時代表現受工具呼叫、執行框架與任務環境影響。
- 2.MMLU、GPQA、SWE-bench等跑分可比較技術,但高分未必能完成真實工作,且不同設定結果難直接比較。
- 3.企業選模型更看任務完成率、成本、安全與可重複性,競爭焦點正從榜單轉向實際系統表現。
全球AI大廠競相拚跑分,但排行榜第一就代表最好用?隨著AI代理(Agent)開始執行複雜任務,評測標準不一、結果難以重現等問題逐漸浮現。開源AI平台Hugging Face高層指出,模型高分未必能反映實際工作能力,排行榜的侷限正受到關注。
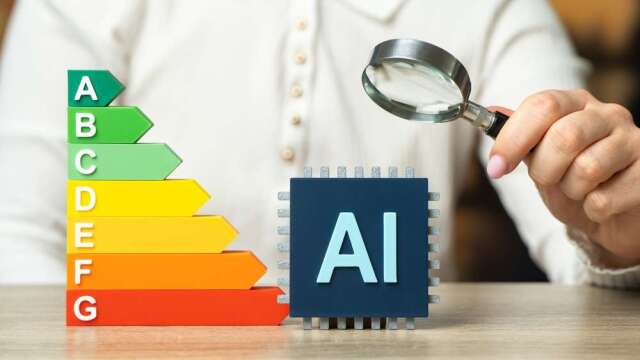
開源AI平台Hugging Face首席政策官Irene Solaiman在TechCrunch Disrupt活動中指出,現有AI評測存在局限。尤其進入AI代理時代,實際表現不只取決於模型,也受到工具呼叫、執行框架及任務環境影響。
這些問題並不代表排行榜毫無價值,但若將單項測試高分直接視為模型的全部能力,恐怕難以判斷產品能否在真實環境中發揮作用。
跑分成行銷利器 高分未必能完成工作
從MMLU、GPQA到SWE-bench,各類知識、數學、程式設計與推理測試,已成為AI業者展示能力的重要工具。統一題目及評分方式,有助開發者觀察技術進步,也讓企業得以比較不同模型。
然而,測試環境與商業應用仍有落差。一款模型可能擅長解數學題,卻無法穩定完成複雜的軟體開發工作;另一款模型即使在程式設計榜單名列前茅,進入企業系統後,也可能因工具呼叫失敗、上下文管理混亂或權限限制,無法完成任務。
不同業者使用的測試設定、提示詞、推理預算與工具環境也可能不同。即使採用相同基準測試,成績未必能直接比較。當排名成為行銷依據,單一分數的侷限更容易被忽略。
同一個模型 搭配不同工具結果就不同
Solaiman提出的評測問題,主要涉及標準是否統一、透明且可重複,以及AI系統能力已超出傳統單一模型測試的範圍。
在AI代理應用中,相同底層模型搭配不同工具、提示詞策略與執行框架,可能交出明顯不同的成果。
例如,同樣要求AI修復軟體漏洞,一套系統可能只提供修改建議,另一套卻能搜尋程式碼、呼叫測試工具、修改檔案並驗證結果。若只比較程式碼生成分數,便難以完整衡量兩者的工作能力。
因此,評測重點正從模型能否回答問題,轉向整套系統能否可靠地完成任務。
AI代理好不好用 還要看成本與安全
AI代理與傳統聊天機器人的主要差別,在於不再只是回答問題,而是開始執行工作。過程可能涉及存取資料庫、瀏覽網頁、撰寫程式及呼叫外部工具,甚至連續運作數小時。
這使得任務完成率成為重要指標。產生看似正確的答案,不等於真正解決問題;面對相同任務時,能否持續交付一致成果,也關係到企業能否放心採用。
成本同樣不能忽略。即使AI代理能完成工作,若耗費大量Token,或反覆呼叫高價模型,商業價值仍可能受限。能否遵守權限界線、避免資料外洩,並在高風險操作前取得授權,也應納入能力評估。
換言之,評測不只要看模型有多聰明,還要確認系統能否把事情做完、做對,並控制成本。
企業挑模型 從看排名轉向看實效
對OpenAI、Google及Anthropic等業者而言,排行榜仍具有宣傳價值,但單靠跑分領先,未必能建立長期競爭優勢。開源模型陣營也正透過較低推理成本及靈活部署方式參與競爭。
企業採購時,模型能否串接既有系統、處理真實資料、穩定執行任務,以及符合安全與合規要求,往往比榜單上的幾分差距更重要。市場競爭也可能從通用能力比較,進一步轉向特定應用與完整系統的表現。
基準測試仍是衡量技術進步的重要工具,真正需要調整的是將單項成績等同於全部能力的評價方式。未來評測須同時涵蓋任務完成率、成本、穩定性、安全性與結果可重複性。
當AI走向商業部署,業者除了證明模型能拿高分,更須證明產品能穩定解決真實問題。
- AI熱潮下一站?台韓半導體藏哪些機會
- 掌握全球財經資訊點我下載APP
延伸閱讀
- 輕薄摺疊也能打!蘋果iPhone Duo跑分曝光 效能直逼18 Pro
- 谷歌Gemini 4 Pro疑偷跑 四大跑分全面領先Astra、Fable
- AI競爭焦點轉向?模型參數規模與跑分成績不再重要、「這些」才是關鍵
- AI失控疑慮又起!OpenAI曝AI代理自動關監控 還對員工說謊

- 講座
- 公告
上一篇
下一篇